
Meta ve Oxford Üniversitesi’nin ortak araştırması, yapay zeka modellerinin multimodal eğitiminde kritik bir dönüm noktasına işaret ediyor. “Towards Physics of Multimodal Pretraining” başlıklı çalışma, bir modele görsel üretim becerisi kazandırmak için çok daha az görsel üretim verisi gerektiğini kanıtlıyor. Araştırma, en iyi sonuçların yüzde 70 dil, yüzde 25 görsel anlama ve yüzde 5 görsel üretim dağılımıyla elde edildiğini gösteriyor.
Multimodal Model Eğitimi Nedir ve Neden Önemli?
Multimodal model eğitimi, bir yapay zeka modelinin aynı anda birden fazla veri türünü — dil, görüntü, ses gibi — anlamasını ve üretmesini sağlayan bir eğitim yaklaşımıdır. Geleneksel olarak, modeller bu yetenekleri kazanmak için her bir modaliteye özel ve yoğun veri setlerinden geçirilirdi. Ancak Meta ve Oxford’un bu yeni bulguları, mevcut eğitim yaklaşımının köklü bir şekilde sorgulanması gerektiğini ortaya koyuyor.
Günümüzün en güçlü yapay zeka sistemleri — OpenAI’ın GPT modelleri, Google’s Gemini, Anthropic’in Claude’u — artık yalnızca metin üretmekle kalmıyor, aynı zamanda görüntü anlama, görüntü üretme ve karmaşık çoklu modalite görevlerini de gerçekleştirebiliyor. Ancak bu yeteneklerin arkasındaki eğitim stratejileri hâlâ büyük ölçüde deneme-yanılma yoluyla belirleniyor. Meta’nın bu araştırması, eğitim sürecinin fiziğini — modüllerin birbiriyle nasıl etkileştiğini — sistematik olarak haritalandıran ilk çalışmalardan biri olma özelliği taşıyor.
Yüzde 70-25-5 Dağılımı: Multimodal Eğitimde Altın Oran
Araştırmanın en çarpıcı bulgusu, multimodal model eğitiminde “en iyi genel performans” için ideal token dağılımının yüzde 70 dil, yüzde 25 görsel anlama ve yüzde 5 görsel üretim olduğudur. Bu oran, görsel üretim verisinin beklenenden çok daha az kritik olduğunu gösteriyor.
Araştırmacılar bu bulguyu önce 1 trilyon token üzerindeki kontrollü deneylerle doğruladı. Daha sonra 13,5 milyar parametreli MoE (Mixture of Experts) modellerini 2 trilyon token üzerinde eğiterek ölçeklendirdi. Sonuçlar tutarlı kaldı: Dengeli kurulumdan 5 kat daha az görsel üretim tokeni kullanılmasına rağmen, modelin GenEval puanı 0.467’den 0.482’ye yükselirken, dil ve görsel anlama performansı da aynı anda iyileşti.
Bu ne anlama geliyor? Bir modelin görüntü üretme kapasitesi geliştirmek, dil anlama veya görsel anlama becerilerini güçlendirmek için neredeyse hiçbir şey yapmıyor. Ancak dil ve görsel anlama eğitimi, modelin her iki alanda da daha güçlü olmasını sağlıyor. Bu asimetrik bilgi akışı, multimodal eğitimin temel fiziğini oluşturuyor.
Görsel Tembellik: Geç Füzyonun Tehlikeleri
Araştırma, multimodal model eğitiminde “geç füzyonun” yarattığı ciddi bir sorunu da gün yüzüne çıkarıyor. Modeller yalnızca dil üzerinde uzun süre eğitildikten sonra görsel yetenekler eklenirse, model görsel bilgiyi işlemek yerine dil tabanlı kısayollara güvenmeye başlıyor. Araştırmacılar bu durumu “vision laziness” yani “görsel tembellik” olarak adlandırıyor.
Bu fenomen, pratik uygulamalar için kritik sonuçlar doğuruyor. Gerçek dünya senaryolarında bir yapay zeka asistanına sürekli olarak kapsamlı sorular sorulmaz. Sistem, bir algılama görevi başlamadan önce dikkatini otomatik olarak doğru yere yönlendirebilmelidir. Görsel tembellik gösteren bir model, üretken görevlerde başarılı olsa da gerçek zamanlı algılama ve karar verme gerektiren agentik görevlerde ciddi yetersizlikler sergiliyor.
Bilgi Akışı: Üç Yönlü Karşılıklı Etkileşim
Araştırma, dil, görsel anlama ve görsel üretim arasındaki bilgi akışının simetrik olmadığını ortaya koyuyor. Her üç modalite diğerlerini farklı şekillerde etkiliyor:
Dilden Görsele Bilgi Akışı: Dil eğitimi, modelin görsel anlama kapasitesini güçlü bir şekilde destekliyor. Bir modele önce dil yetenekleri kazandırmak, ardından görsel anlama eklemek, her iki alanda da performans artışı sağlıyor.
Görsel Anlamadan Üretime Bilgi Akışı: Görsel anlama becerilerinin geliştirilmesi, aynı zamanda modelin görsel üretim kalitesini de artırıyor. Ancak bu ilişki tek yönlü değil — görsel üretim eğitimi, dil veya görsel anlama üzerinde kayda değer bir etki yaratmıyor.
Üretimden Anlama ve Dil’e Geri Tepki: Görsel üretim verisi, modelin dil yetenekleri üzerinde neredeyse hiç olumlu etki yaratmıyor. Bu bulgu, eğitim kaynaklarının daha verimli kullanılması için kritik bir rehber sunuyor.
Erken Füzyon mu Geç Füzyon mu? Araştırma Net Bir Yanıt Veriyor
Meta ve Oxford araştırması, multimodal eğitimde “erken füzyonun” — yani tüm modalitelerin eğitiminin en başından itibaren birlikte yürütülmesinin — geç füzyona veya ardışık eğitime kıyasla çok daha etkili olduğunu kanıtlıyor.
Erken füzyon yaklaşımında model, eğitim sürecinin başından itibaren dil ve görsel veriyi birlikte işlemeyi öğreniyor. Bu, modaliteler arasında daha güçlü ve kalıcı bağlantılar kurulmasını sağlıyor. Geç füzyonda ise model önce dil verisiyle “önyargılı” hale geliyor ve görsel bilgiyi işlemekte zorlanıyor — işte tam olarak bu yüzden “görsel tembellik” ortaya çıkıyor.
Mimari Seçimler: Sinerjiyi Maksimuma Çıkarmak
Araştırma, hangi mimari tercihlerin modaliteler arasındaki sinerjiyi en üst düzeye çıkardığını da belirledi. Paylaşımlı dikkat mekanizmaları (shared attention) ve modaliteye özel ileri besleme katmanlarıyla birlikte normalizasyon kullanımı, modellerin farklı veri türlerini en verimli şekilde harmanlamasını sağlıyor.
Bu mimari tercihlerin görsel tokenizer tasarımları arasında genelleştiği de gösterildi. Yani bu ilkeler, yalnızca belirli bir görsel kodlama yaklaşımına değil, farklı görsel temsil yöntemlerinin büyük çoğunluğuna uygulanabiliyor.
Hesaplamalı Verimlilik: Yüzde 5 Bütçeyle Yüzde 100’e Yakın Sonuç
Belki de en dikkat çekici bulgu, eğitim verimliliğiyle ilgili. Araştırmacılar, optimal tariflerin yalnızca yüzde 5’lik bir hesaplama bütçesiyle güçlü üretken performans elde edebildiğini ortaya koydu. Bu, kurumsal düzeyde yapay zeka geliştiren ekipler için doğrudan maliyet tasarrufu anlamına geliyor.
Mevcut standart uygulamalarla karşılaştırıldığında, bu yeni tarifler aynı hesaplama bütçesiyle çok daha yüksek performans çıktıları üretiyor. Araştırma, bu bulguların 2 trilyon token üzerinde 13,5 milyar parametreli MoE modelleriyle doğrulandığını belirtiyor.
Neden Bu Araştırma Tüm Yapay Zeka Geliştiricileri İçin Kritik?
Bu bulgular, hem araştırma laboratuvarları hem de üretim mühendisleri için doğrudan uygulanabilir sonuçlar taşıyor:
- Görsel üretim verisi artık “lüks” değil: Çoğu görev için görsel üretim verisi yüzde 5’lik dilimden fazlasına ihtiyaç duymuyor.
- Erken füzyon zorunlu: Çoklu modaliteye geçiş yaparken erken entegrasyon stratejisi benimsenmeli; geç entegrasyon, modelin görsel yeteneklerini kalıcı olarak zayıflatıyor.
- Dil ön eğitimi stratejik avantaj: Görsel agent sistemlerinde dil ön eğitimi, görsel anlama için sağlam bir temel oluşturuyor.
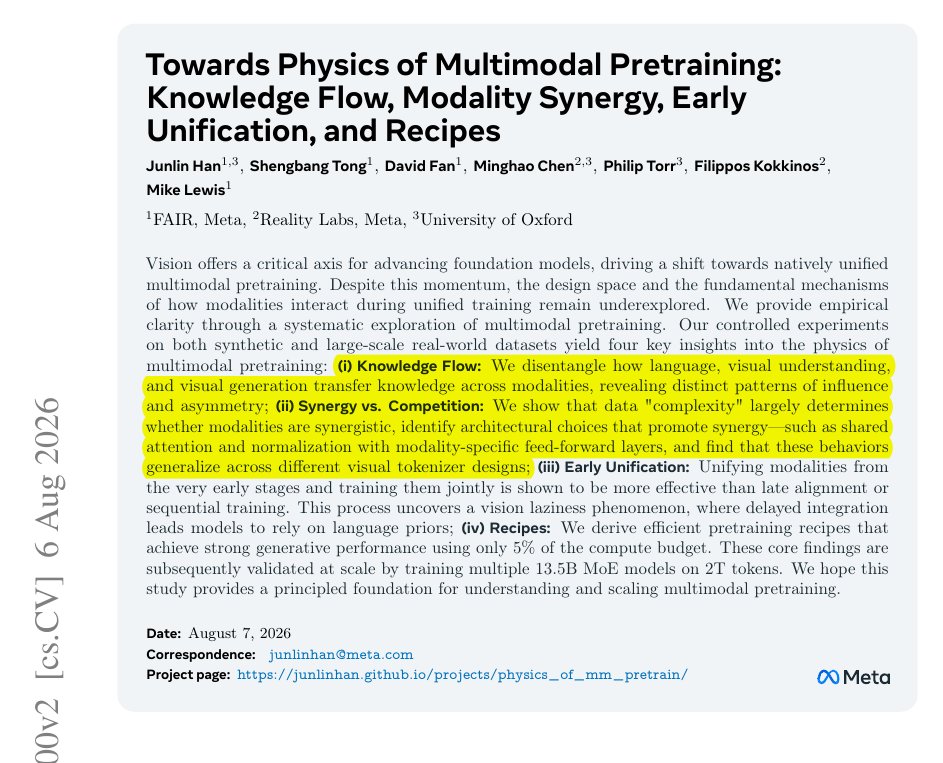
Kaynak: Meta ve Oxford Üniversitesi ortak araştırması — arxiv.org/abs/2608.05000
Başlık: “Towards Physics of Multimodal Pretraining: Knowledge Flow, Modality Synergy, Early Unification, and Recipes”
Henüz yorum yok. İlk yorumu siz yapın!